アリババクラウド、ゲームやエンタメのMaaSとして日本市場に力を入れる
アリババクラウドが日本に4カ所目のAIデータセンターを置く、などゲームやエンターテンイメント産業に強い日本市場を重視し始めた。学習したAIモデルを公開するオープンウェイトモデル(後述)を使い、LLM(大規模言語モデル)ベースのテキストや画像・動画の生成AIをサービス提供することに力を入れる。AIデータセンターではNvidiaのGPUは言うまでもないが、自社の独自AIチップも導入している。
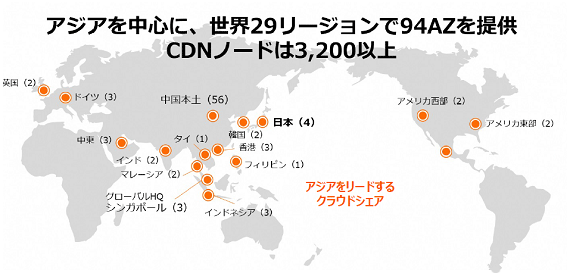
図1 世界各地にデータセンターを設置するアリババクラウド 出典:アリババクラウド
アリババクラウドは、関東地区に4カ所のデータセンターを設置したことで、世界29の地域にデータセンターを94カ所設けたことになる。同社はEC(電子商取引)サイトを運営する中国のアリババとは完全別に動いており、アリババクラウドの本社はシンガポールに置いている。ここで世界中のデータセンターを管理しており、世界中に生成AIサービスを提供する。
生成AIサービスで提供する生成AIモデルとして、テキストや画像・動画生成など汎用的なQwenと、画像・動画の生成に特化したWanを提供する。共にオープンウェイトモデルで、完全なオープンソースとは異なり、学習のウェイト(重み)あるいはパラメータだけを公開している。オープンソースがソースコードを公開し自由に改変したり再配布したりできるのに対して、オープンウェイトは、学習済みのモデルを公開し自由に利用できるモデルのこと。改変などはできない。
Qwenは、テキストだけではなく画像や音声などマルチモーダルな生成AIモデル(図2)。オープンウェイトモデルの数は400を超えるという。またそのモデルをダウンロードした数は10億に達するとしている。201もの言語に対応しており、3970億パラメータという巨大なモデルではあるが、このうち170億パラメータだけを活性化し分野に特化した活用ができるという。
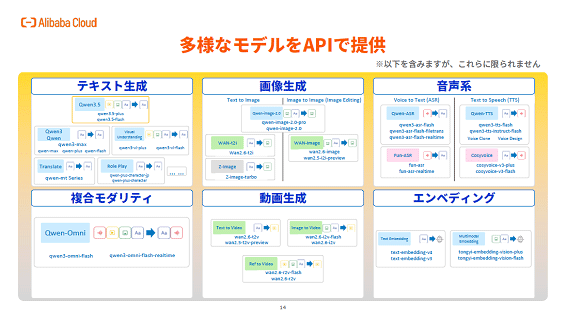
図2 テキスト生成から画像、動画生成など多様なモデルを提供 出典:アリババクラウド
例えばQwen 3.5の日本語OCRでは日本語の文字認識を精度よく出力する。またQwen 3の音声モデルでは会議録音で話者を分離区別できるほか、最大12時間の録音が可能でテキストを出力する。リアルタイムでテキストに変換するだけではなく、人の声をまねるクローンボイス機能もある。また音声ファイルからテキスト読み上げ出力もある。
マルチモーダルな画像/動画生成モデルWanでは、画像生成、動画生成が可能であり、テキストベースで動画を生成するだけではなく、写真などの静止画をベースに動画を生成することもできる。また、最大5枚の静止画などを参照キャラクタとして入力してから、新しいシーンでの動画を生成することもできる。例えば参照ベースの動画生成では、Wan 2.6を使い、子供の写真を数枚入力しただけで、子供が勉強しているシーンを動画で15秒間出力できる。Wanは写真レベルの質感と自然なリアリスティックな光と影を表現する。
生成AIはさまざまな産業に応用が利く上に、産業的にも金融業界や医療ヘルスケア業界などでの利用を推進するIBMやNvidiaのようなAIビジネスとは違い、アリババクラウドはゲームやエンターテインメント産業での応用を日本市場で狙っている。
アリババクラウドの日本法人であるアリババクラウドジャパンサービスのジェネラルマネージャーである栗田岳史氏は、2029年までの3年間で日本法人の人員を2.5倍に増やすと述べており、AIのコモディティ化を推進するという。これまでモデルを高機能化し、2025年にはQwen 3、26年にはQwen3.5をリリースした。ゲームやエンターテインメント分野でコスト・パフォーマンスの高さが差別要因となると栗田氏は述べている。
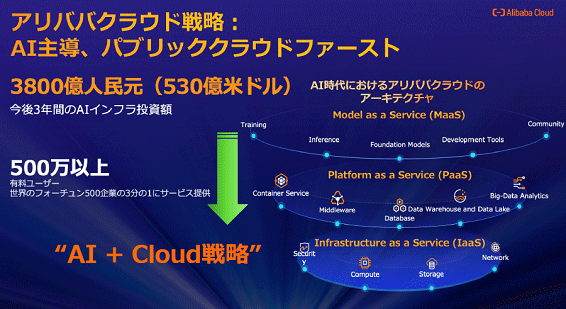
図3 フルスタックのAIを手掛けるアリババクラウド 出典:アリババクラウド
アリババクラウドはフルスタックのAIの提供を考えており(図3)、AIチップやコンピュータのようなハードウエア(インフラ)から、ミドルウエアや開発プラットフォーム、さらにMaaS(Model as a Service)まで提供している。
同社が構築するAIデータセンターではNvidiaのGPUをベースにしたハードウエア(コンピュータ)を構成しているが、自社設計の独自AIチップも複数使っているという。